Zespół NPROFIT · Opublikowano:
Roboty AI w logach serwera mają trzy role: zbierają treści do trenowania modeli, budują indeks wyszukiwarki w czacie albo pobierają stronę, bo ktoś właśnie zadał pytanie. OpenAI pisze wprost, że ustawienia dla tych robotów są niezależne, więc zakaz trenowania nie musi wyłączać firmy z odpowiedzi ChatGPT.
Twardy ślad użycia treści zostawiają pobrania na prośbę użytkownika i odesłania widoczne w analityce.
W skrócie
- Trening, indeks wyszukiwania i pobranie na prośbę użytkownika to osobne roboty z osobnymi regułami.
- Zakaz dla GPTBot nie usuwa strony z wyszukiwania ChatGPT. Robi to dopiero zakaz dla OAI-SearchBot.
- Google-Extended nie ma własnego nagłówka w logach: strony pobierają dotychczasowe roboty Google.
- W sieci Cloudflare 80% crawlingu AI w ciągu 12 miesięcy służyło treningowi, a 2% działaniom użytkowników.
- Prawdziwego robota rozpoznasz po adresie IP z listy operatora, nie po samym nagłówku User-Agent.
Trzy role robotów AI i co każda z nich znaczy dla firmy
Wiersz w logu z nazwą GPTBot, ClaudeBot albo Perplexity-User wygląda podobnie, ale każdy z nich oznacza coś innego dla sprzedaży. Każdy robot ma inny cel, a od celu zależy, co tracisz, gdy go zablokujesz.
- Robot treningowy zbiera treści, które mogą trafić do zbioru uczącego przyszłego modelu. Nie przyprowadza nikogo na stronę.
- Robot wyszukiwania buduje indeks, z którego czat wybiera źródła do odpowiedzi z linkami. Od niego zależy, czy strona może trafić do odpowiedzi z wyszukiwania.
- Pobranie na prośbę użytkownika następuje, gdy ktoś pyta czat o temat albo wkleja adres. Za takim wierszem w logu stoi człowiek z konkretnym pytaniem.
Dokumentacja robotów OpenAI mówi wprost, że ustawienia dla poszczególnych robotów są od siebie niezależne: można wpuścić robota wyszukiwania, żeby pojawiać się w wynikach, a przy tym zablokować robota treningowego. Z naszej perspektywy to dla firmy dwie osobne decyzje. Pierwsza dotyczy praw do treści, druga obecności w odpowiedziach, które czytają potencjalni klienci.
OpenAI, Anthropic i Perplexity: osobny robot do każdej roli
Trzej operatorzy czatów z wyszukiwaniem publikują listę robotów z nazwami, celem i zasadami. Tabela zestawia deklaracje z ich dokumentacji.
| Robot | Operator i rola | robots.txt | Weryfikacja |
|---|---|---|---|
| GPTBot | OpenAI: trening modeli | stosuje się | lista IP gptbot.json |
| OAI-SearchBot | OpenAI: wyszukiwanie w ChatGPT | stosuje się, zmiana po ok. 24 h | lista IP searchbot.json |
| ChatGPT-User | OpenAI: pobranie na prośbę użytkownika | reguły mogą nie obowiązywać | lista IP chatgpt-user.json |
| ClaudeBot | Anthropic: trening modeli | stosuje się, obsługuje Crawl-delay | lista adresów w pomocy Anthropic |
| Claude-SearchBot | Anthropic: indeks wyszukiwania | stosuje się | lista adresów w pomocy Anthropic |
| Claude-User | Anthropic: pobranie na prośbę użytkownika | stosuje się | lista adresów w pomocy Anthropic |
| PerplexityBot | Perplexity: wyniki wyszukiwania, bez treningu | Perplexity zaleca wpuścić | lista IP perplexitybot.json |
| Perplexity-User | Perplexity: pobranie na prośbę użytkownika | zwykle ignoruje | lista IP perplexity-user.json |
Szczegóły, które zmieniają decyzję
OpenAI pisze, że strona zablokowana dla OAI-SearchBot nie będzie pokazywana w odpowiedziach wyszukiwania ChatGPT, choć może się w nich pojawić jako link nawigacyjny. Zmiana pliku robots.txt dociera do wyników po około 24 godzinach.
Centrum pomocy Anthropic deklaruje, że wszystkie trzy roboty tej firmy stosują się do robots.txt, także Claude-User. Ostrzega też, że blokada po adresach IP może nie działać trwale, bo uniemożliwia robotowi odczyt pliku robots.txt.
Perplexity w dokumentacji robotów przyznaje, że Perplexity-User zwykle ignoruje robots.txt, bo pobranie zlecił użytkownik. OpenAI pisze o ChatGPT-User ostrożniej: reguły mogą nie mieć zastosowania.
Zakaz w robots.txt działa na roboty, które same chodzą po sieci. Pobrania zlecone przez człowieka część operatorów traktuje osobno, bo za każdym stoi konkretne pytanie.
Google, Apple, Amazon i Common Crawl: co naprawdę widać w logach
Google-Extended nie jest robotem. Dokumentacja typowych robotów Google podaje: „Google-Extended nie ma osobnego ciągu znaków klienta użytkownika w żądaniu HTTP.” Strony pobiera zwykły Googlebot, a token w robots.txt decyduje tylko, czy treść może służyć do trenowania modeli Gemini i do groundingu w aplikacjach Gemini.
Google dodaje: „Google-Extended nie ma wpływu na uwzględnienie witryny w wyszukiwarce Google ani nie jest używany jako czynnik decydujący o pozycji w rankingu w wyszukiwarce Google.” Zakaz dla tego tokenu nie kosztuje więc pozycji.
Strona Google o funkcjach AI w wyszukiwarce wyjaśnia, że AI jest wbudowane w wyszukiwarkę, więc sterowaniem jest robots.txt dla Googlebota oraz reguły nosnippet, data-nosnippet, max-snippet i noindex. Kto chciałby zniknąć z przeglądów od AI, musiałby ograniczyć widoczność strony w samym Google.
Osobna grupa to moduły pobierania uruchamiane przez użytkownika, na przykład Google-NotebookLM i Google-Read-Aloud. Google pisze o nich: „Żądanie pobierania pochodzi od użytkownika, dlatego moduły te ignorują zwykle reguły zawarte w pliku robots.txt.”
Apple, Amazon i Common Crawl
- Apple: Applebot-Extended nie pobiera stron, tylko decyduje, czy dane zebrane przez Applebota mogą trenować modele Apple. Reguł dla niego Apple nie bierze pod uwagę w rankingu wyszukiwania.
- Amazon: Amazonbot może zasilać trening modeli AI Amazona, Amzn-SearchBot nie zbiera treści do treningu, a Amzn-User może nie stosować wszystkich reguł robots.txt.
- Common Crawl: fundacja ostrzega, że niektóre roboty fałszywie podają się za CCBot. Prawdziwego pozwala sprawdzić przez odwrotny DNS.
Zdarzają się też pomyłki w nazwach. W audycie robots.txt 14 000 domen (okres 2023-2024, domeny źródłowe korpusów C4, RefinedWeb i Dolma) 4,5% witryn blokowało nazwy anthropic-ai albo Claude-Web, ale nie ClaudeBot, czyli robota, którego Anthropic faktycznie używa.
Ile ruchu robią roboty AI według danych Cloudflare i Fastly
Roboty AI to wciąż niewielka część ruchu. W podsumowaniu roku 2025 Cloudflare Radar roboty AI odpowiadały w sieci Cloudflare średnio za 4,2% żądań stron HTML, a sam Googlebot za 4,5%. Udział wahał się w ciągu roku od 2,4% do 6,4%.
Cel tych wizyt jest wyraźny. Według analizy Cloudflare w ostatnich 12 miesiącach objętych analizą 80% crawlingu AI w sieci Cloudflare służyło treningowi, 18% wyszukiwaniu i 2% działaniom użytkowników. Cloudflare przypisuje cel robotom na podstawie deklaracji operatorów i źródeł branżowych. Wykres porównuje dwa pojedyncze miesiące.
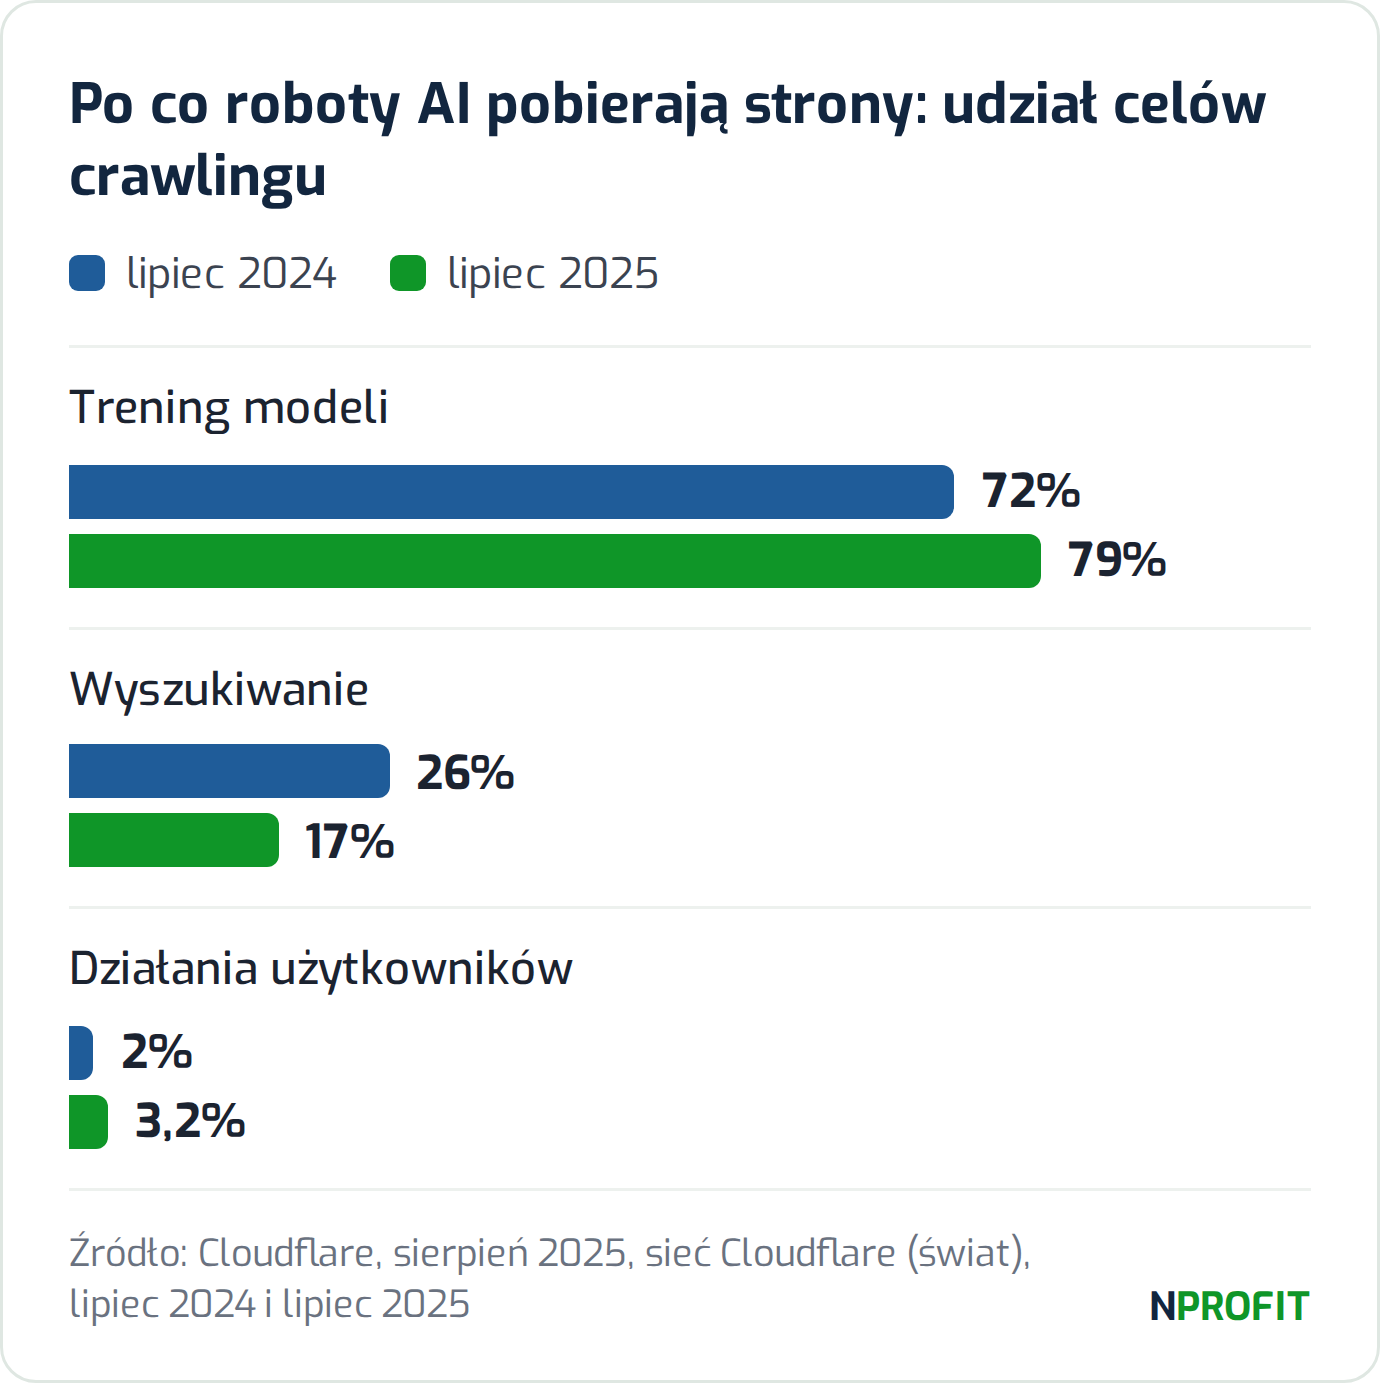
Najmniejsza grupa szybko rośnie. W sieci Cloudflare crawling na potrzeby działań użytkowników wzrósł w 2025 roku ponad 21-krotnie od stycznia do początku grudnia, a szczytowe wolumeny ChatGPT-User były nawet 16 razy wyższe niż na początku roku. To ten ruch odpowiada na pytania zadawane czatom tu i teraz.
Fastly: crawlery kontra pobrania na żądanie
Fastly dzieli ruch inaczej. Od kwietnia do lipca 2025 crawlery stanowiły w sieci Fastly prawie 80% ruchu robotów AI, a fetchery, czyli pobrania na żądanie, pozostałe 20%.
Wśród fetcherów w sieci Fastly dominuje jeden operator: boty OpenAI wygenerowały 98% ich żądań. Autorzy zastrzegają, że część fetcherów korzysta z danych zaindeksowanych wcześniej przez wyszukiwarki, więc liczba ta mówi tyle samo o sposobie pobierania co o popularności ChatGPT.
Fastly odnotował też w swojej sieci w niektórych przypadkach skoki do 39 000 żądań fetcherów na minutę. Fastly zauważa, że dla stron, które zwykle nie mają takiego ruchu, przypomina to warunki ataku DDoS, choć bez złych intencji.
Proporcje zależą od regionu. W Europie crawlery stanowiły w sieci Fastly 41% ruchu robotów AI, czyli mniej niż połowę, wobec blisko 90% w Ameryce Północnej.
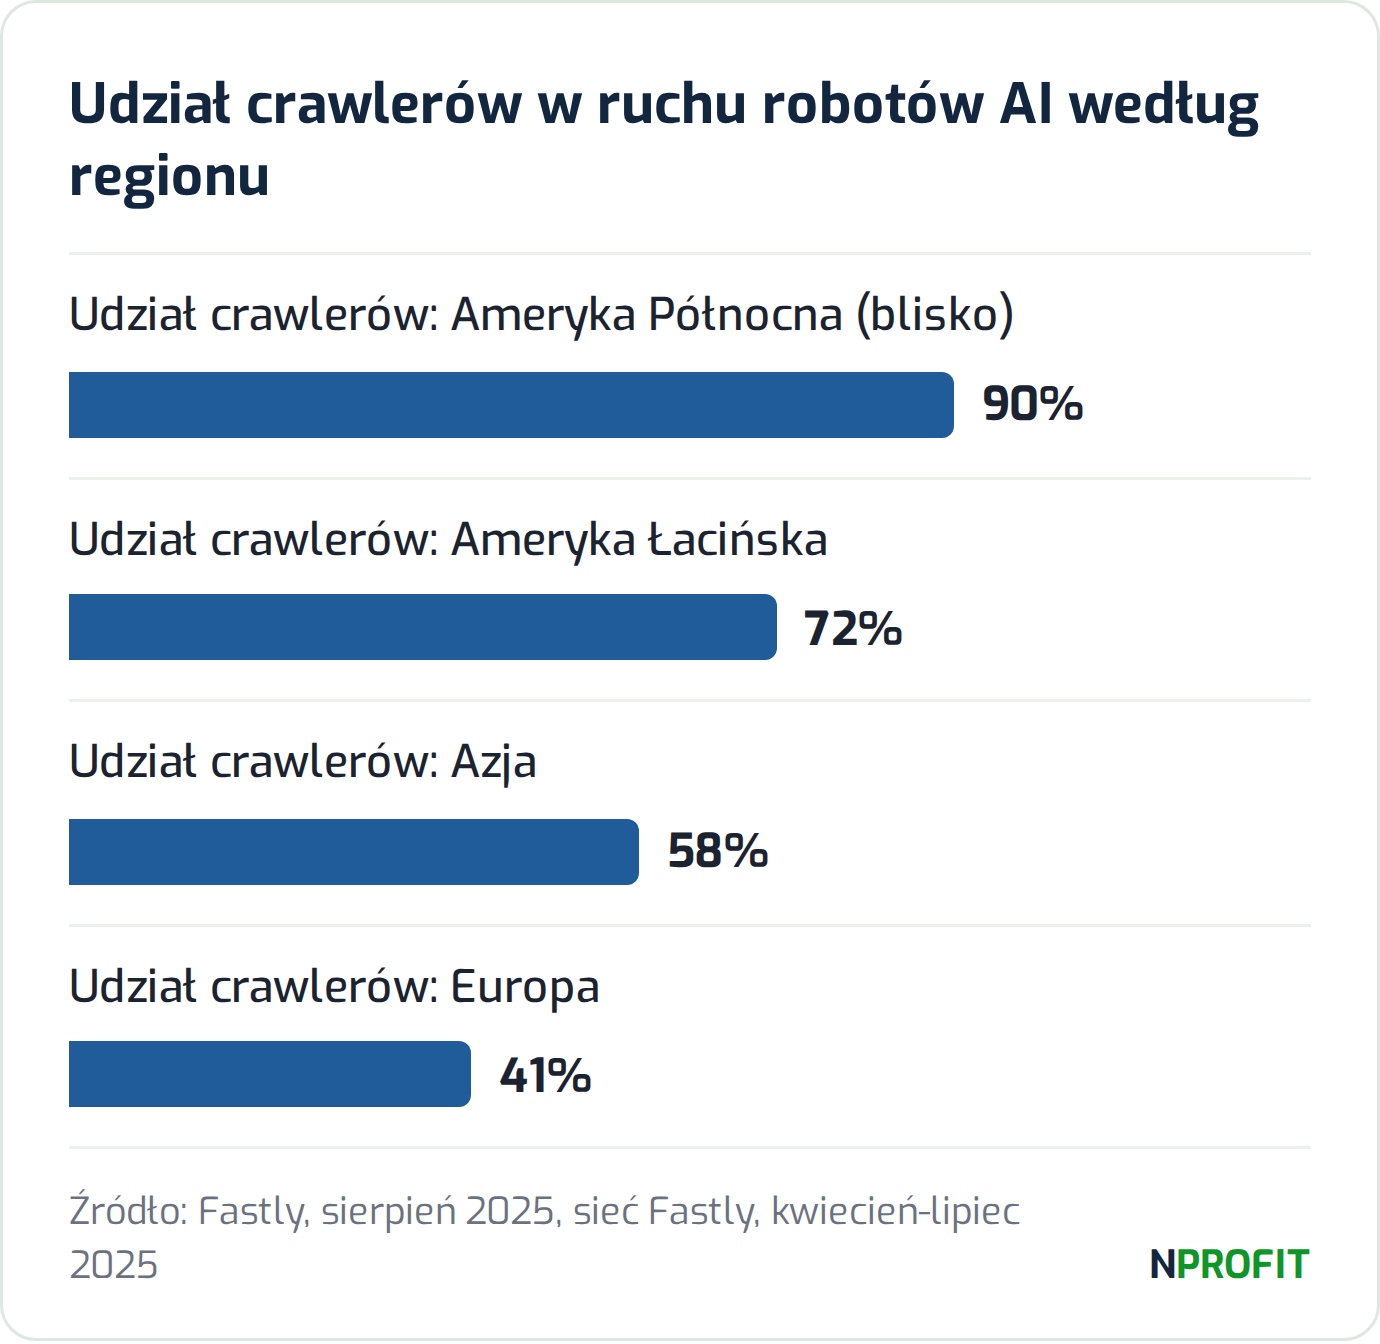
Zbieranie treści do treningu nikogo nie przyprowadza na stronę. Proporcje zależą od sieci i regionu, ale o użyciu treści w odpowiedziach mówią dopiero pobrania na prośbę użytkownika.
Pobrania kontra odesłania: ile stron na jedną wizytę z czatu
Cloudflare mierzy to wskaźnikiem crawl-to-refer. Metoda Cloudflare dzieli liczbę żądań stron HTML od robotów danej platformy przez liczbę wejść na strony HTML, w których nagłówek Referer wskazuje tę platformę. Im wyższa liczba, tym więcej pobrań przypada na jednego odwiedzającego.
Wyniki z sieci Cloudflare dla poszczególnych platform:
- Anthropic: 38 000 pobranych stron na jedno odesłanie w lipcu 2025, mimo spadku o 87% od początku roku.
- Perplexity: 194 pobrania na jednego odwiedzającego w lipcu 2025.
- OpenAI: wskaźnik skakał, a w marcu 2025 sięgnął 3700 do 1.
- Google: od nieco ponad 3 do 1 na początku roku do 30 do 1 w kwietniu, w połowie lipca znów 3 do 1.
Cloudflare sam wskazuje słabość tej miary. Wejścia z natywnej aplikacji Claude nie przekazują nagłówka Referer i autorzy zakładają, że podobnie jest w innych aplikacjach, więc wskaźniki mogą być zawyżone w nieznanym stopniu.
Dla firmy wniosek jest praktyczny. Sama liczba wizyt GPTBot czy ClaudeBot nie mówi nic o tym, czy czat poleca Twoją stronę. Mówią o tym pobrania na prośbę użytkownika w logach i odesłania z asystentów w analityce, bo oba ślady powstają dopiero wtedy, gdy ktoś pyta.
W naszej praktyce obecność w AI mierzymy po stronie serwera, po ruchu robotów AI, oraz w Google Analytics, po odesłaniach. Odpowiedzi czatów różnią się między użytkownikami, więc odpytywanie stałej listy pytań nie daje wyniku, który da się porównać w czasie. Szerzej o tym, skąd biorą się spadki kliknięć przy stojących pozycjach, piszemy we wpisie o kliknięciach zabieranych przez odpowiedzi AI.
Czy roboty AI słuchają robots.txt: eksperyment na uczelni w USA
Deklaracje operatorów to jedno, pomiar to drugie. Badanie naukowe z 2025 roku objęło około 3,9 mln żądań do 36 witryn uczelni w Stanach Zjednoczonych od 12 lutego do 29 marca 2025 roku.
Badacze wdrażali kolejne wersje robots.txt na jednej witrynie, każdą na dwa tygodnie, od wersji bez istotnych ograniczeń po zakaz dostępu. Wersje pośrednie wymagały odstępu 30 sekund między pobraniami albo dopuszczały tylko jeden katalog.
Im ostrzejsza reguła, tym mniej robotów się do niej stosowało. Na tle reszty wyróżniały się GPTBot, ClaudeBot i Amazonbot, które według autorów wyraźnie starały się przestrzegać każdej z trzech wersji pliku.
Ważniejsze dla właściciela strony jest tempo. Mniej niż 40% robotów asystentów AI i wyszukiwarek AI sprawdzało robots.txt ponownie w ciągu tygodnia, więc zmiana pliku dociera do nich z opóźnieniem.
Autorzy przyznają, że ich metoda nie pozwala jednoznacznie stwierdzić, czy dany robot podszywa się pod cudzą nazwę. Do tego dane pochodzą z witryn jednej uczelni z 40 dni.
Gdy robot zmienia nazwę: przypadek z 2025 roku
Cloudflare opisał test na nowo kupionych, nieindeksowanych domenach z zakazem w robots.txt. Według Cloudflare Perplexity po zablokowaniu swoich robotów pobierało treść przeglądarką podszywającą się pod Chrome na macOS, z adresów spoza oficjalnej listy, na dziesiątkach tysięcy domen.
W tym samym teście ChatGPT-User pobrał plik robots.txt i przestał pobierać stronę, gdy zakaz go obejmował. Cloudflare oferuje klientom własne narzędzia do blokowania robotów AI, co warto brać pod uwagę przy czytaniu tych ocen.
Robots.txt to prośba, a nie zamek. Zmiana pliku działa z opóźnieniem, a nazwa w nagłówku niczego nie dowodzi, dopóki nie sprawdzisz adresu.
Jak sprawdzić w logach serwera, czy robot AI jest prawdziwy
Nagłówek User-Agent wpisuje sam klient, więc każdy może się w nim przedstawić jako GPTBot. Google ostrzega w dokumentacji: „ciąg znaków klienta użytkownika HTTP może być sfałszowany.” Rozstrzyga adres IP.
- Wyfiltruj z logu wiersze z nazwami robotów: GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, Amazonbot, Applebot, CCBot i Googlebot.
- Dla OpenAI i Perplexity porównaj adres z plikiem JSON danego robota. Amazon publikuje osobną listę adresów dla każdego z trzech swoich robotów. Perplexity zaleca dopasowywać każdy robot do jego własnych zakresów.
- Dla Google, Apple i CCBota wykonaj odwrotne zapytanie DNS, a potem zwykłe zapytanie o otrzymaną nazwę. Google opisuje to w instrukcji: adres musi wrócić ten sam.
- Domena z odwrotnego DNS musi należeć do operatora. U Google to googlebot.com, google.com albo googleusercontent.com.
- Policz ruch osobno dla treningu, wyszukiwania i pobrań na prośbę użytkownika. Zestaw pobrania na żądanie z odesłaniami z asystentów AI w analityce.
Apple podaje w dokumentacji domenę applebot.apple.com. Common Crawl pokazuje przykład nazwy w domenie crawl.commoncrawl.org. Anthropic pisze, że adres źródłowy z jego listy oznacza robota Anthropic, ale nie opisuje weryfikacji przez DNS.
Czego robot AI na stronie nie zobaczy
Pomiar Vercel i MERJ w sieci Vercel wykazał, że żaden z głównych robotów AI nie wykonywał JavaScriptu. Roboty ChatGPT i Claude pobierały pliki JavaScript (11,50% i 23,84% żądań), ale ich nie uruchamiały.
Wyjątkiem w sieci Vercel był Gemini, który korzysta z infrastruktury Googlebota. Treść oferty ładowana dopiero skryptem w przeglądarce może więc dla większości czatów nie istnieć, a w logu zobaczysz wtedy wizytę robota bez żadnego efektu w odpowiedziach.
Co wpuścić, a co zablokować: decyzja dla firmy
Ustawienia zależą od tego, czego firma chce. Tabela zestawia trzy typowe cele z trzema rolami robotów. To nasze zestawienie na podstawie dokumentacji operatorów opisanej wyżej.
| Cel firmy | Robot wyszukiwania | Robot treningowy | Pobranie na prośbę |
|---|---|---|---|
| Być źródłem w odpowiedziach czatów | wpuścić | osobna decyzja | wpuścić |
| Nie oddawać treści do treningu | wpuścić | zablokować | wpuścić |
| Odciążyć słaby serwer | wpuścić | Crawl-delay tam, gdzie działa | wpuścić, wzmocnić hosting |
Blokada robota wyszukiwania to dobrowolna nieobecność w odpowiedziach. Anthropic pisze, że wyłączenie Claude-SearchBot może zmniejszyć widoczność strony w wynikach wyszukiwania Claude.
Zakaz treningu kosztuje mniej. OpenAI wskazuje, że zakaz dla GPTBot nie zmienia ustawień OAI-SearchBot, od którego zależy wyszukiwanie w ChatGPT. Google-Extended według Google nie wpływa na pozycje w wyszukiwarce. Jak to wygląda w WordPressie, pokazujemy we wpisie o blokowaniu robotów AI. Wykonawca SEO ustawia takie reguły razem z resztą pliku robots.txt i sprawdza ich skutek w logach.
Obecność w odpowiedziach wyrasta z tych samych podstaw co pozycje w Google: treści, którą robot może przeczytać, linków i techniki strony. Jak przygotować treść, którą modele chętnie cytują, opisujemy we wpisie o AIO, a całość tej pracy na stronie o pozycjonowaniu.
Kryterium jest proste: jeśli w logach widzisz ChatGPT-User, Claude-User albo Perplexity-User na stronach ofertowych, a w analityce odesłania z asystentów, czaty używają Twojej treści. Sam ruch GPTBot i ClaudeBot znaczy tylko, że treść pobrano i może trafić do zbioru uczącego.
Najczęstsze pytania
Czy zablokowanie GPTBot usuwa stronę z ChatGPT?
Nie. GPTBot zbiera treści do trenowania modeli OpenAI. O obecności w wyszukiwaniu ChatGPT decyduje OAI-SearchBot: OpenAI pisze, że strona zablokowana dla tego robota nie będzie pokazywana w odpowiedziach wyszukiwania, choć może zostać jako link nawigacyjny. Oba ustawienia są od siebie niezależne.
Czym różni się ChatGPT-User od OAI-SearchBot?
OAI-SearchBot automatycznie buduje indeks wyszukiwania w ChatGPT. ChatGPT-User wchodzi na stronę dopiero wtedy, gdy użytkownik zada pytanie ChatGPT albo własnemu GPT. Nie służy do automatycznego crawlingu. OpenAI zaznacza, że w takim przypadku reguły robots.txt mogą nie obowiązywać.
Czy Google-Extended wpływa na pozycje w Google?
Nie. Google pisze, że Google-Extended nie wpływa na uwzględnienie witryny w wyszukiwarce ani na pozycję w rankingu. Ten token nie ma też własnego nagłówka w logach: strony pobiera zwykły Googlebot, a Google-Extended decyduje tylko o trenowaniu modeli Gemini i groundingu w aplikacjach Gemini.
Jak sprawdzić, czy GPTBot w logach jest prawdziwy?
Porównaj adres IP z wiersza logu z zakresami w pliku openai.com/gptbot.json. Każdy robot OpenAI ma osobny plik: searchbot.json dla OAI-SearchBot i chatgpt-user.json dla ChatGPT-User. Wizyta z adresu spoza listy z nazwą GPTBot w nagłówku to robot, który się podszywa.
Czy roboty AI widzą treść ładowaną przez JavaScript?
Według pomiaru Vercel i MERJ w sieci Vercel główne roboty AI nie wykonywały JavaScriptu, choć roboty ChatGPT i Claude pobierały same pliki skryptów. Wyjątkiem był Gemini, korzystający z infrastruktury Googlebota. Z naszej perspektywy treść, która ma trafić do odpowiedzi, najbezpieczniej umieścić w kodzie HTML strony.
Źródła
- OpenAI: Overview of OpenAI Crawlers: GPTBot, OAI-SearchBot, ChatGPT-User: cele, robots.txt, listy IP, czas zmian
- Anthropic: Does Anthropic crawl data from the web (Claude Help Center): ClaudeBot, Claude-SearchBot, Claude-User, Crawl-delay, blokada po IP
- Perplexity: Perplexity Crawlers: PerplexityBot i Perplexity-User, listy IP, stosunek do robots.txt
- Google Search Central: Typowe roboty Google: Google-Extended jako token bez własnego nagłówka, brak wpływu na ranking
- Google Search Central: Moduły pobierania uruchamiane przez użytkownika: pobrania na żądanie i robots.txt
- Google Search Central: Weryfikowanie żądań robotów Google: procedura odwrotnego i zwykłego DNS
- Google Search Central: Funkcje AI a Twoja witryna: sterowanie przeglądami od AI przez Googlebota i nosnippet
- Apple: About Applebot: Applebot-Extended, weryfikacja w domenie applebot.apple.com
- Amazon: Amazonbot, Amzn-SearchBot, Amzn-User: role trzech robotów Amazona i robots.txt
- Common Crawl: CCBot: fałszywe CCBoty i weryfikacja przez odwrotny DNS
- Cloudflare: The crawl-to-click gap (2025): cele crawlingu AI, wskaźniki pobrań do odesłań w 2025
- Cloudflare: 2025 Cloudflare Radar Year in Review: udział robotów AI w żądaniach HTML, wzrost pobrań na żądanie
- Cloudflare: The crawl before the fall of referrals (2025): metoda crawl-to-refer i jej ograniczenia
- Cloudflare: Perplexity is using stealth, undeclared crawlers (2025): test z robots.txt, zachowanie Perplexity i ChatGPT-User
- Fastly: AI Bots in Q2 2025, Threat Insights Report: crawlery i fetchery AI, udział OpenAI, skoki ruchu
- Longpre i in.: Consent in Crisis (arXiv, 2024): błędne nazwy robotów Anthropic w robots.txt
- Kim i in.: Scrapers Selectively Respect robots.txt Directives (IMC 2025): zmierzona zgodność robotów z robots.txt
- Vercel i MERJ: The rise of the AI crawler (2024): roboty AI a JavaScript